AMD против облака: когда своя AI-станция начинает экономить
Следите за новостями по этой теме!
Подписаться на «Рифы и пачки / Твоя культура»
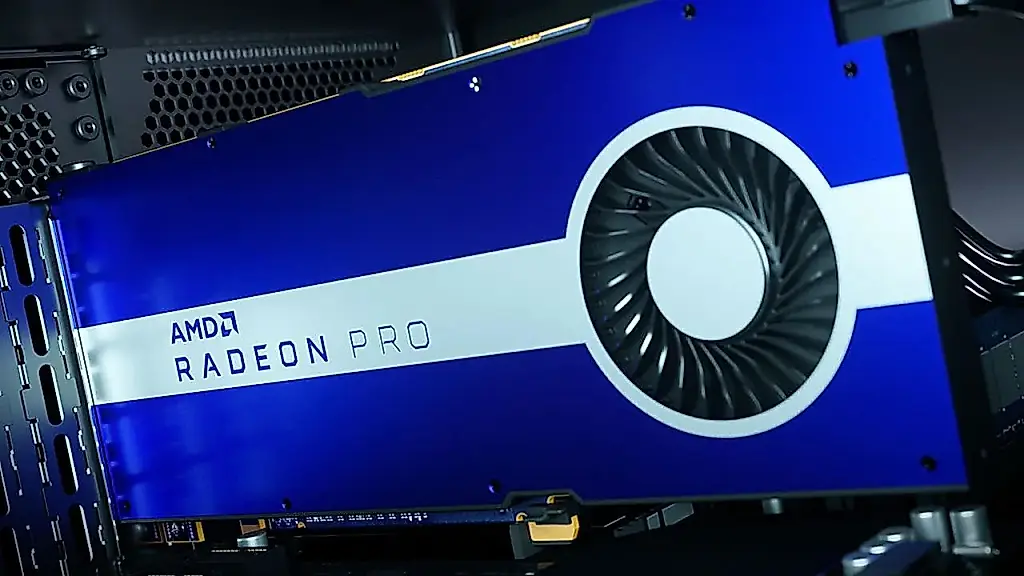
Аппаратный обозреватель сравнил рабочую станцию с двумя видеокартами AMD Radeon AI PRO R9700 и облачные тарифы для ИИ, чтобы выяснить, когда собственное оборудование оказывается дешевле оплаты генерации токенов. В каждой карте установлено по 32 ГБ памяти, а стоимость всей станции в рассматриваемой конфигурации составила примерно 18 775 долларов.
В расчёт включили потребление электричества, скорость обработки токенов и амортизацию оборудования — то есть постепенное распределение его цены по сроку использования. Затем результат сопоставили с облачными тарифами, где компания платит за каждый миллион сгенерированных токенов. Указанные цены варьируются от 1,20 доллара за миллион токенов для GPT-5.6 Luna до 30 долларов для GPT-5.6 Sol. Между ними находятся Claude Sonnet 5 с тарифом 10 долларов и Claude Opus 5 за 25 долларов за миллион выходных токенов.
При одновременной работе двух R9700 станция выдавала 156,2 токена в секунду при обслуживании восьми пользователей. Технология Multi-Token Prediction, предсказывающая несколько токенов за один шаг, почти вдвое увеличила показатель — до 320,2 токена в секунду без заметного изменения качества ответа.
При такой скорости станции достаточно работать 3,5 часа в неделю, чтобы превзойти по экономике GPT-5.6 Sol. Для Claude Opus 5 порог составляет 4,2 часа, а для Gemini 3.1 Pro — 8,8 часа в неделю. Если команда ежемесячно генерирует более 20 млн токенов по тарифу GPT-5.6 Sol, собственная система действительно начинает приносить заметную экономию.
В этом сценарии годовые расходы на электричество и амортизацию оцениваются примерно в 6262 доллара. Сопоставимый облачный счёт составил бы около 18 000 долларов в год. Разница — 11 738 долларов в пользу собственной станции.
Но с дешёвыми облачными моделями магия быстро заканчивается. Для GPT-5.6 Luna, который стоит 1,20 доллара за миллион токенов, станции пришлось бы работать 94,3 часа в неделю только для выхода в ноль. Неделя, напомним, содержит 168 часов, поэтому такой режим потребовал бы почти постоянной загрузки.
Электричество оказалось не главным фактором: две карты вместе потребляли от 310 до 510 ватт при длительной нагрузке. Для небольшой команды результат ещё менее впечатляющий. При генерации 5 млн токенов в месяц с расчётом по тарифу Gemini 3.1 Pro облачные расходы составили бы около 720 долларов в год, тогда как собственная станция потребовала бы 6262 доллара. Экономия здесь превращается в убыток.
Есть и более доступный вариант. Одна R9700 самостоятельно запускала модель с 8 млрд параметров со скоростью 34,5 токена в секунду. Такая конфигурация потребляла от 221 до 283 ватт в зависимости от числа одновременных пользователей и стоила около 1880 долларов, тогда как комплект из двух карт оценивался в 3760 долларов. Небольшим моделям и лёгким рабочим нагрузкам одной карты может хватить, чтобы оправдать покупку значительно раньше.
Однако цена токена — не единственный критерий. Локальные модели уступают ведущим облачным системам в сложном рассуждении. В одном независимом индексе модель AMD с 27 млрд параметров набрала 37 баллов, тогда как Gemini 3.1 Pro получила 46. Иными словами, компания может сэкономить на облачном счёте, но заплатить качеством ответов. Финальный вывод прост: AMD-станция выгодна при большой и регулярной нагрузке, особенно если используется дорогая облачная модель. Для редких запросов или дешёвого тарифа облако остаётся рациональнее.
PEREC.RU
Материал сравнивает экономику локального запуска ИИ на рабочей станции с двумя видеокартами AMD Radeon AI PRO R9700 и оплатой облачных моделей по числу сгенерированных токенов. Полная конфигурация стоит около 18 775 долларов, в каждой карте установлено по 32 ГБ памяти. Автор оценки учитывает не только первоначальную стоимость, но и потребление электроэнергии, скорость генерации и амортизацию оборудования.
При совместной работе две карты обрабатывают 156,2 токена в секунду для восьми одновременных пользователей. Multi-Token Prediction увеличивает скорость до 320,2 токена в секунду при сохранении качества вывода. При этой производительности собственная станция быстрее достигает экономического преимущества перед дорогими облачными моделями: для GPT-5.6 Sol достаточно 3,5 часа работы в неделю, для Claude Opus 5 — 4,2 часа, для Gemini 3.1 Pro — 8,8 часа.
Наиболее убедительный сценарий возникает при нагрузке свыше 20 млн токенов в месяц. Тогда расходы на электроэнергию и амортизацию оцениваются в 6262 доллара в год, тогда как сопоставимое использование GPT-5.6 Sol обошлось бы примерно в 18 000 долларов. Экономия достигает 11 738 долларов.
Однако собственное оборудование не является универсально выгодным решением. При использовании дешёвого GPT-5.6 Luna по 1,20 доллара за миллион токенов станции нужно работать 94,3 часа еженедельно, чтобы сравняться с облаком. Для небольшой команды, создающей 5 млн токенов в месяц по тарифу Gemini 3.1 Pro, облачные расходы составят около 720 долларов в год, а владение станцией — 6262 доллара. Электропотребление двух карт, составляющее 310–510 ватт, влияет на результат меньше, чем цена оборудования и объём нагрузки.
Одна карта R9700 запускает модель с 8 млрд параметров со скоростью 34,5 токена в секунду и потребляет 221–283 ватта. Её стоимость около 1880 долларов, поэтому для небольших моделей и лёгких задач одиночная конфигурация может иметь более разумную точку окупаемости, чем комплект из двух карт стоимостью около 3760 долларов.
Главный компромисс связан не только с деньгами. Локальные модели уступают крупным облачным системам в сложном рассуждении: в одном независимом индексе модель AMD с 27 млрд параметров получила 37 баллов против 46 у Gemini 3.1 Pro. Следовательно, компания, выбирающая локальный запуск ради экономии, может пожертвовать качеством ответов. Собственная AMD-станция оправдана при высокой и регулярной загрузке, особенно при замене дорогих облачных моделей; для малых объёмов и дешёвых тарифов облако остаётся выгоднее и проще.