Jalapeño против Nvidia: OpenAI показала чип, который экономит энергию, но не отменяет зависимость от конкурента
Следите за новостями по этой теме!
Подписаться на «Рифы и пачки / Твоя культура»
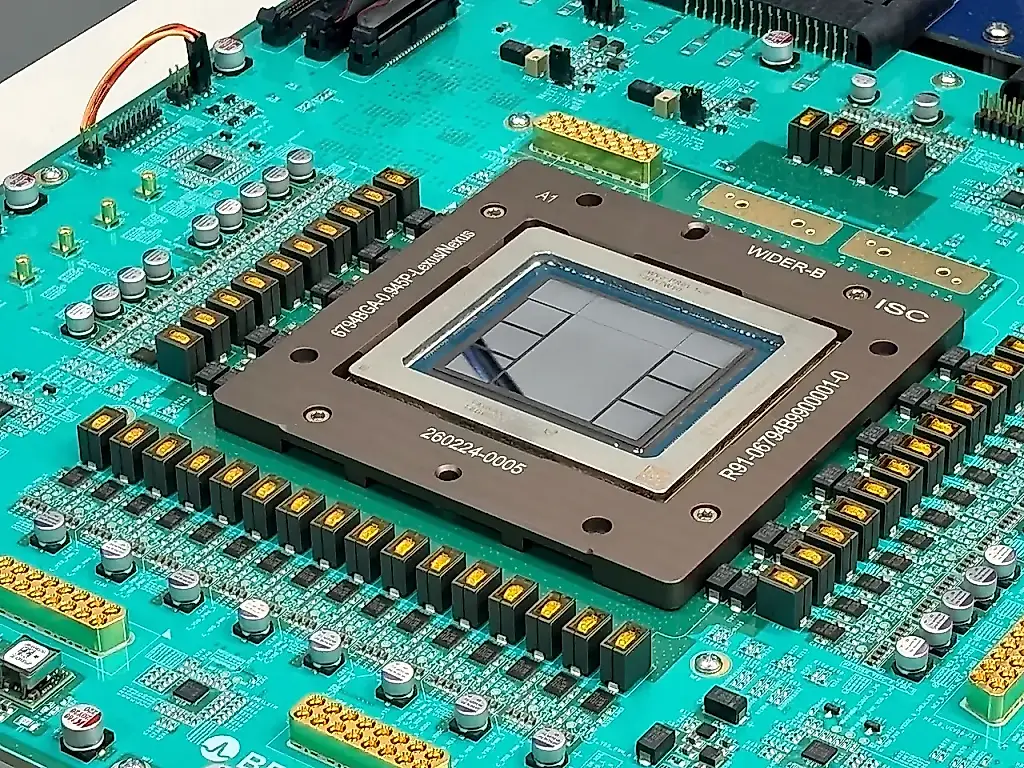
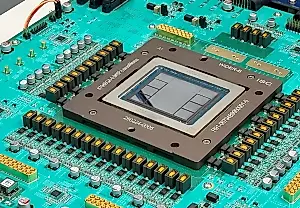
OpenAI впервые раскрыла результаты тестирования собственного ускорителя Jalapeño — специализированного чипа для инференса, то есть запуска уже обученных моделей и генерации ответов. Презентация состоялась 25 августа на конференции Hot Chips. Чип разработан совместно с Broadcom, а опубликованные цифры явно подобраны вокруг энергоэффективности — области, где OpenAI может наиболее выгодно сравниваться с Nvidia.
В тестах на трех открытых моделях Jalapeño показал от 1,5 до 1,9 раза большую производительность на киловатт и от 1,7 до 3,6 раза меньшую сквозную задержку по сравнению с протестированными системами Nvidia. Сам ускоритель рассчитан на потребление 700 Вт, тогда как сопоставимые решения Nvidia оценивались в 1200 и 1400 Вт. Это важное преимущество для дата-центров, где электричество, охлаждение и плотность размещения оборудования превращаются в отдельную статью расходов.
Jalapeño — ASIC, то есть интегральная схема специального назначения. В отличие от универсальных ускорителей, такой чип оптимизируют под конкретные задачи. В данном случае речь идет прежде всего об инференсе OpenAI: запуске нескольких моделей с меньшими затратами энергии и времени. Руководитель аппаратной программы OpenAI Richard Ho назвал результаты «очень значительным технологическим рывком» относительно современных решений.
Компания использовала публичный набор тестов InferenceX от SemiAnalysis. Проверялись GPT-OSS 120B, DeepSeek R1 670B и Kimi K2.5 от Moonshot AI. Для каждой модели применялись примерно 8000 входных и 1000 выходных токенов — токенами называют фрагменты текста, из которых языковая модель собирает запрос и ответ.
На GPT-OSS 120B Jalapeño показал преимущество по эффективности в 1,9 раза против системы GB200. На DeepSeek R1 670B и Kimi K2.5 результат составил соответственно 1,7 и 1,5 раза против GB300. При этом сравнение GPT-OSS 120B на GB300 с Jalapeño OpenAI не опубликовала, оставив в таблице аккуратное белое пятно.
И здесь начинается бухгалтерия впечатлений. OpenAI сравнивала производительность на киловатт, а не на один чип. Такой подход не обязательно неверен: энергоэффективность действительно важна. Но он позволяет Jalapeño выглядеть гораздо более опасным соперником Nvidia, чем при сравнении абсолютной мощности.
GB300 в опубликованных испытаниях оставался более производительным решением в целом. Тем временем Nvidia уже разворачивает следующее поколение Vera Rubin, о котором OpenAI ничего не сообщила в контексте прямого сравнения. Nvidia представляет Vera Rubin как особенно энергоэффективную платформу с памятью HBM4.
Есть и другие оговорки. Jalapeño тестировали только с предсказанием одного токена за раз, без speculative decoding — метода, при котором система заранее предлагает несколько возможных токенов, — и без разделения этапов обработки входа и генерации ответа. В промышленных развертываниях Nvidia часто применяется многотокенное предсказание. При сравнении Jalapeño с GB300 в такой конфигурации максимальное преимущество OpenAI по эффективности сокращается примерно до 1,5 раза.
Архитектура Jalapeño должна уменьшать перемещение данных и задержки связи. Ядра и память HBM разделены на секции, причем каждое вычислительное ядро получает быстрый доступ к собственной области памяти. Синхронизация вынесена в отдельную сеть коллективного обмена данными.
Каждый корпус сочетает вычислительный кристалл с шестью стеками HBM4. В сумме это 216 ГиБ памяти с пропускной способностью 15,4 ТБ/с. Для сравнения, GB300 располагает 288 ГБ HBM3E: у Nvidia больше емкость, у Jalapeño — заметно выше пропускная способность и примерно на 50% больше памяти на каждый ватт расчетной мощности.
Все опубликованные данные относятся к версии A0 — первому варианту кремния. Более эффективная ревизия B0 уже производится и, по оценке OpenAI, даст примерно на 25% лучшую производительность на ватт. Массовое производство планируют постепенно наращивать в течение 2027 года.
До уровня Vera Rubin Jalapeño, вероятно, не дотягивает, но OpenAI может быть достаточно и более узкой победы. Александр Харроуэлл из Omdia назвал разработку крупнейшей конкурентной угрозой для Nvidia: около половины капитальных затрат на ИИ-инфраструктуру приходится на компании, которые уже создают собственные чипы или способны это делать. Адриен Санчес из Yole Group считает, что удар прежде всего придется по марже Nvidia в сегменте инференса — самой быстрорастущей части ее бизнеса.
Ситуация выглядит особенно неловко из-за финансовой связи сторон. Nvidia недавно согласилась обеспечить финансирование на 105 млрд долларов для будущего объекта OpenAI в Огайо. При этом OpenAI по-прежнему нуждается в большом количестве чипов Nvidia, а Richard Ho называет компанию «очень хорошим партнером».
Противоречия, впрочем, нет. Jalapeño — специализированный ASIC главным образом для инференса, тогда как ускорители Nvidia остаются критически важными для обучения новых моделей. Для Nvidia новость все равно неприятна: один из двух крупнейших покупателей оборудования для инференса уже не просто мечтает о домашней альтернативе, а показывает рабочие результаты. Монополия, как обычно, начинает нервничать именно тогда, когда ей предлагают платить за электричество отдельно.
PEREC.RU
OpenAI представила первые опубликованные результаты Jalapeño — специализированного ASIC-ускорителя, разработанного совместно с Broadcom для инференса, то есть запуска уже обученных ИИ-моделей. Презентация прошла 25 августа на конференции Hot Chips. Ключевой акцент компании — энергоэффективность, а не абсолютная производительность.
Jalapeño рассчитан на 700 Вт. Сравниваемые системы Nvidia оценивались в 1200 и 1400 Вт. В тестах на трех открытых моделях OpenAI заявила 1,5–1,9-кратное преимущество по производительности на киловатт и снижение сквозной задержки в 1,7–3,6 раза. Проверялись GPT-OSS 120B, DeepSeek R1 670B и Kimi K2.5 от Moonshot AI при номинальных 8000 входных и 1000 выходных токенах.
На GPT-OSS 120B Jalapeño оказался в 1,9 раза эффективнее GB200. На DeepSeek R1 670B и Kimi K2.5 преимущество составило 1,7 и 1,5 раза соответственно против GB300. Однако OpenAI не раскрыла сравнение GPT-OSS 120B на GB300. Кроме того, расчеты велись на киловатт, а не на чип, что выгодно подчеркивает низкое энергопотребление Jalapeño, но не доказывает превосходство по абсолютной мощности.
GB300 остается более мощным ускорителем в целом, а Nvidia уже продвигает Vera Rubin с памятью HBM4. Тесты OpenAI проводились с однотокенным предсказанием, без speculative decoding и без разделения этапов обработки входа и генерации. При конфигурации GB300 с многотокенным предсказанием максимальное преимущество Jalapeño по эффективности сокращается примерно до 1,5 раза.
Архитектура Jalapeño ориентирована на сокращение перемещения данных: вычислительные ядра и HBM распределены по секциям, а синхронизация идет через отдельную коллективную сеть. В каждом корпусе установлен вычислительный кристалл и шесть стеков HBM4 — 216 ГиБ памяти с пропускной способностью 15,4 ТБ/с. GB300 имеет 288 ГБ HBM3E, но Jalapeño обеспечивает примерно на 50% больше памяти на ватт.
Все опубликованные показатели получены на версии A0 — первом варианте кремния. Ревизия B0 уже выпускается и должна повысить производительность на ватт примерно на 25%. Производство планируют постепенно наращивать в 2027 году.
Эксперты Omdia называют Jalapeño крупнейшей конкурентной угрозой Nvidia, поскольку около половины капитальных расходов на ИИ-инфраструктуру приходится на компании, которые уже разрабатывают собственные чипы или могут начать это делать. Yole Group связывает угрозу прежде всего с маржой Nvidia в инференсе — наиболее быстрорастущем сегменте.
Анонс прозвучал на фоне тесных финансовых отношений компаний: Nvidia согласилась обеспечить финансирование на 105 млрд долларов для будущего объекта OpenAI в Огайо. OpenAI при этом продолжает закупать у Nvidia большое количество ускорителей. Причина проста: Jalapeño создан главным образом для инференса, тогда как обучение новых моделей по-прежнему требует универсальных решений Nvidia. Разработка OpenAI не отменяет зависимость от Nvidia, но показывает, что в сегменте инференса у монополии появляется серьезный соперник.