Jalapeño contra Nvidia: OpenAI presenta un chip que ahorra energía, pero no elimina su dependencia del rival

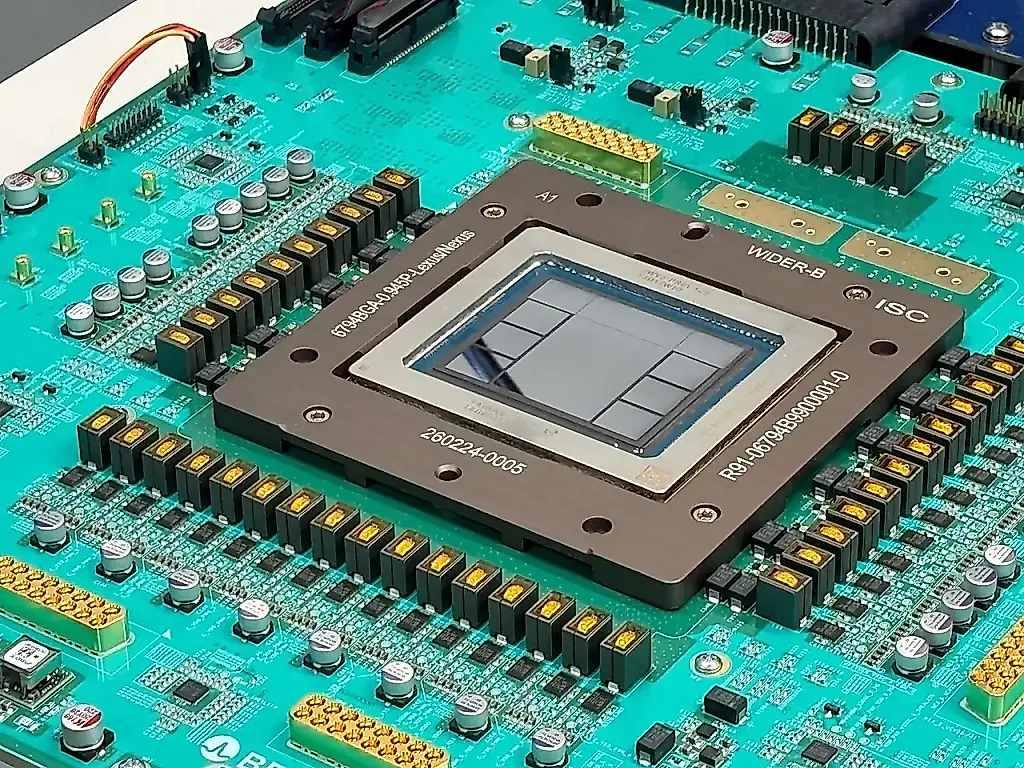
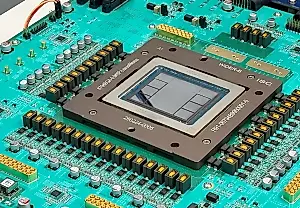
OpenAI ha revelado por primera vez los resultados de las pruebas de su propio acelerador Jalapeño, un chip especializado para inferencia, es decir, para ejecutar modelos ya entrenados y generar respuestas. La presentación tuvo lugar el 25 de agosto en la conferencia Hot Chips. El chip se ha desarrollado junto con Broadcom y las cifras publicadas se centran claramente en la eficiencia energética, el terreno en el que OpenAI puede compararse con Nvidia en mejores condiciones.
En las pruebas con tres modelos abiertos, Jalapeño obtuvo entre 1,5 y 1,9 veces más rendimiento por kilovatio y entre 1,7 y 3,6 veces menos latencia de extremo a extremo que los sistemas de Nvidia evaluados. El acelerador está diseñado para consumir 700 W, mientras que las soluciones comparables de Nvidia se estimaron en 1200 y 1400 W. Es una ventaja importante para los centros de datos, donde la electricidad, la refrigeración y la densidad de los equipos se convierten en partidas de gasto independientes.
Jalapeño es un ASIC, es decir, un circuito integrado de aplicación específica. A diferencia de los aceleradores de propósito general, este tipo de chip se optimiza para tareas concretas. En este caso, se trata sobre todo de la inferencia de OpenAI: ejecutar varios modelos con menos gasto de energía y tiempo. Richard Ho, responsable del programa de hardware de OpenAI, calificó los resultados de «un avance tecnológico muy significativo» respecto a las soluciones actuales.
La empresa utilizó el conjunto público de pruebas InferenceX de SemiAnalysis. Se evaluaron GPT-OSS 120B, DeepSeek R1 670B y Kimi K2.5, de Moonshot AI. Para cada modelo se emplearon unos 8000 tokens de entrada y 1000 de salida: los tokens son fragmentos de texto con los que el modelo de lenguaje construye la consulta y la respuesta.
Con GPT-OSS 120B, Jalapeño demostró una eficiencia 1,9 veces superior a la del sistema GB200. En DeepSeek R1 670B y Kimi K2.5, los resultados fueron, respectivamente, 1,7 y 1,5 veces mejores que los de GB300. Sin embargo, OpenAI no publicó la comparación entre GPT-OSS 120B en GB300 y Jalapeño, dejando en la tabla un pulcro espacio en blanco.
Y aquí empieza la contabilidad de las impresiones. OpenAI comparó el rendimiento por kilovatio, no por chip. El enfoque no es necesariamente incorrecto: la eficiencia energética sí importa. Pero permite que Jalapeño parezca un rival mucho más peligroso para Nvidia de lo que parecería al comparar la potencia absoluta.
En las pruebas publicadas, GB300 seguía siendo la solución más potente en conjunto. Mientras tanto, Nvidia ya está desplegando la siguiente generación, Vera Rubin, sobre la que OpenAI no dijo nada en el contexto de una comparación directa. Nvidia presenta Vera Rubin como una plataforma especialmente eficiente desde el punto de vista energético y equipada con memoria HBM4.
También hay otras salvedades. Jalapeño se probó prediciendo un solo token cada vez, sin speculative decoding —un método por el que el sistema propone de antemano varios tokens posibles— y sin separar las fases de procesamiento de la entrada y generación de la respuesta. En los despliegues industriales de Nvidia se usa a menudo la predicción de varios tokens. Al comparar Jalapeño con GB300 en esa configuración, la ventaja máxima de OpenAI en eficiencia se reduce a aproximadamente 1,5 veces.
La arquitectura de Jalapeño debería reducir el movimiento de datos y la latencia de comunicación. Los núcleos y la memoria HBM se dividen en secciones, y cada núcleo de cálculo tiene acceso rápido a su propia zona de memoria. La sincronización se gestiona a través de una red independiente de intercambio colectivo de datos.
Cada encapsulado combina un chip de cálculo con seis pilas de HBM4. En total, ofrece 216 GiB de memoria con un ancho de banda de 15,4 TB/s. Como referencia, GB300 dispone de 288 GB de HBM3E: Nvidia tiene más capacidad, mientras que Jalapeño ofrece un ancho de banda claramente superior y aproximadamente un 50 % más de memoria por cada vatio de potencia de cálculo nominal.
Todos los datos publicados corresponden a la versión A0, la primera iteración del silicio. Ya se está fabricando una revisión más eficiente, la B0, que, según OpenAI, ofrecerá alrededor de un 25 % más de rendimiento por vatio. La producción en masa se irá ampliando a lo largo de 2027.
Probablemente Jalapeño no alcance el nivel de Vera Rubin, pero a OpenAI puede bastarle con una victoria más limitada. Alexander Harrowell, de Omdia, calificó el desarrollo de la mayor amenaza competitiva para Nvidia: cerca de la mitad del gasto de capital en infraestructura de IA corresponde a empresas que ya desarrollan sus propios chips o que podrían hacerlo. Adrien Sanchez, de Yole Group, cree que el golpe afectará sobre todo a los márgenes de Nvidia en el segmento de inferencia, la parte de su negocio que más rápido crece.
La situación resulta especialmente incómoda por los vínculos financieros entre ambas partes. Nvidia aceptó recientemente aportar 105.000 millones de dólares de financiación para las futuras instalaciones de OpenAI en Ohio. Al mismo tiempo, OpenAI sigue necesitando grandes cantidades de chips de Nvidia, y Richard Ho califica a la empresa de «muy buen socio».
No hay contradicción. Jalapeño es un ASIC especializado principalmente en inferencia, mientras que los aceleradores de Nvidia siguen siendo esenciales para entrenar nuevos modelos. La noticia sigue siendo desagradable para Nvidia: uno de los dos mayores compradores de equipos de inferencia ya no se limita a soñar con una alternativa propia, sino que presenta resultados funcionales. Como suele ocurrir, el monopolio empieza a ponerse nervioso justo cuando le ofrecen pagar la electricidad por separado.
PEREC.RU
OpenAI ha presentado los primeros resultados publicados de Jalapeño, un acelerador ASIC especializado desarrollado junto con Broadcom para inferencia, es decir, para ejecutar modelos de IA ya entrenados. La presentación tuvo lugar el 25 de agosto en la conferencia Hot Chips. La empresa pone el foco en la eficiencia energética, no en el rendimiento absoluto.
Jalapeño está diseñado para consumir 700 W. Los sistemas de Nvidia comparados se estimaron en 1200 y 1400 W. En pruebas con tres modelos abiertos, OpenAI afirmó que Jalapeño ofrece entre 1,5 y 1,9 veces más rendimiento por kilovatio y reduce entre 1,7 y 3,6 veces la latencia de extremo a extremo. Se probaron GPT-OSS 120B, DeepSeek R1 670B y Kimi K2.5, de Moonshot AI, con unos 8000 tokens de entrada y 1000 de salida.
Con GPT-OSS 120B, Jalapeño fue 1,9 veces más eficiente que GB200. En DeepSeek R1 670B y Kimi K2.5, la ventaja fue de 1,7 y 1,5 veces, respectivamente, frente a GB300. Sin embargo, OpenAI no publicó la comparación de GPT-OSS 120B en GB300. Además, los cálculos se hicieron por kilovatio, no por chip: esto pone de relieve el bajo consumo de Jalapeño, pero no demuestra que supere a sus rivales en potencia absoluta.
GB300 sigue siendo el acelerador más potente en conjunto, y Nvidia ya promociona Vera Rubin con memoria HBM4. OpenAI realizó las pruebas prediciendo un token cada vez, sin speculative decoding ni separación entre el procesamiento de la entrada y la generación. Con GB300 configurado para predecir varios tokens, la ventaja máxima de Jalapeño en eficiencia se reduce a aproximadamente 1,5 veces.
La arquitectura de Jalapeño busca reducir el movimiento de datos: los núcleos de cálculo y la memoria HBM se distribuyen en secciones, y la sincronización se realiza mediante una red colectiva independiente. Cada encapsulado incorpora un chip de cálculo y seis pilas de HBM4: 216 GiB de memoria con un ancho de banda de 15,4 TB/s. GB300 tiene 288 GB de HBM3E, pero Jalapeño ofrece alrededor de un 50 % más de memoria por vatio.
Todas las cifras publicadas corresponden a la versión A0, la primera iteración del silicio. La revisión B0 ya está en producción y debería elevar el rendimiento por vatio en torno a un 25 %. La producción se ampliará gradualmente en 2027.
Expertos de Omdia consideran que Jalapeño es la mayor amenaza competitiva para Nvidia, ya que cerca de la mitad del gasto de capital en infraestructura de IA corresponde a empresas que ya desarrollan chips propios o podrían empezar a hacerlo. Yole Group vincula la amenaza, sobre todo, a los márgenes de Nvidia en inferencia, su segmento de crecimiento más rápido.
El anuncio llega en un contexto de estrechos vínculos financieros entre las empresas: Nvidia aceptó aportar 105.000 millones de dólares de financiación para las futuras instalaciones de OpenAI en Ohio. OpenAI sigue comprando grandes cantidades de aceleradores de Nvidia. La razón es sencilla: Jalapeño se ha creado principalmente para inferencia, mientras que entrenar nuevos modelos sigue requiriendo las soluciones de propósito general de Nvidia. El desarrollo de OpenAI no elimina su dependencia de Nvidia, pero demuestra que el monopolio ya tiene un rival serio en el segmento de inferencia.