Nvidia inventa una memoria, pero no para todos

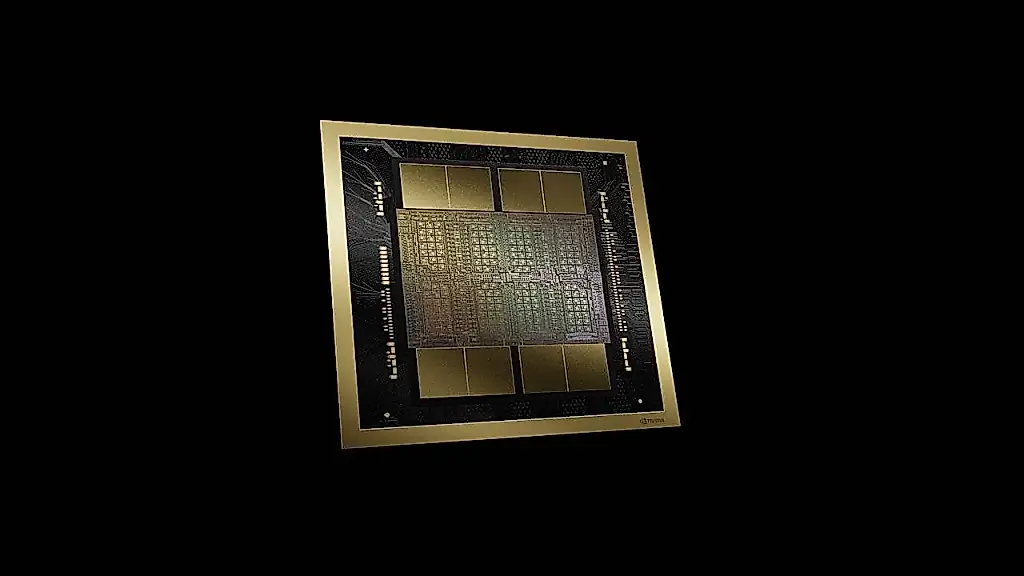
Nvidia amplió el 26 de agosto el programa NVLink Fusion y presentó NVHBM, una arquitectura de memoria especializada de alto ancho de banda. La compañía promete hasta un 30 % más de ancho de banda por pila de memoria, un 15 % menos de consumo energético de HBM y hasta un 25 % más de superficie útil en el chip del acelerador.
La comparación se realizó con muestras de la memoria estándar HBM4E. Según los planes actuales, la propia HBM4E debería empezar a distribuirse a gran escala hacia 2027. Es decir, Nvidia ya muestra el siguiente giro del timón tecnológico mientras el anterior aún está calentando el motor.
El primer socio de Nvidia anunciado públicamente ha sido Amazon Annapurna Labs. El nuevo desarrollo aborda un problema que limita cada vez más los modelos de inteligencia artificial más potentes: las unidades de cálculo pueden procesar datos más rápido de lo que la memoria tarda en transmitírselos. Como resultado, a veces un acelerador caro se queda parado a la espera de la siguiente tanda de información.
La idea principal de NVHBM no consiste en inventar por completo un nuevo tipo de memoria, sino en trasladar un componente clave. En el esquema habitual, el proveedor de memoria fabrica una pila DRAM y un chip base, mientras que el desarrollador del acelerador coloca el controlador de memoria y la interfaz física en su propio chip de cálculo.
La conexión entre ambos está estandarizada por JEDEC, una organización internacional que desarrolla estándares para semiconductores. Sin embargo, el esquema HBM estándar utiliza un bus paralelo muy ancho y relativamente lento. Nvidia propone eliminar la frontera entre ambas partes: trasladar el controlador de memoria al chip base de la pila tridimensional y sustituir el bus estándar por una conexión en serie más estrecha entre chips. Nvidia diseña la conexión y los fabricantes de memoria podrán implementarla.
Según el blog técnico de Nvidia, este enfoque puede reducir hasta un 67 % la superficie de la interfaz y de los componentes auxiliares frente al estándar JEDEC HBM4E. Al mismo tiempo, la compañía asegura que mejoran el consumo energético, el ancho de banda de la memoria y la superficie útil del acelerador.
Pero la idea no surgió de la nada. En diciembre de 2024, Marvell presentó un enfoque similar y anunció como socios a Micron, Samsung y SK hynix. Entonces, la compañía prometió hasta un 25 % más de superficie de cálculo, hasta un 33 % más de capacidad de memoria y una reducción del 70 % en el consumo energético de la interfaz de memoria. Son cifras parecidas a las previsiones actuales de Nvidia.
Neil Shah, analista de Counterpoint Research, resumió la situación así: «La tecnología no es nueva. Lo nuevo es su difusión». En otras palabras, la cuestión ya no es solo quién ideó la arquitectura, sino también quién tendrá acceso a ella.
Y el acceso no es sencillo. HBM4E aún no se fabrica a gran escala: Samsung envió las primeras muestras a finales de mayo de 2026 y SK hynix retrasó su propia fase de envíos de prueba hasta aproximadamente junio. NVHBM está aún más lejos de llegar al mercado general. No es un estándar independiente para cualquier fabricante, sino un componente cuyo acceso está vinculado al programa NVLink Fusion.
NVLink Fusion está pensado para conectar aceleradores de terceros a la plataforma de rack de Nvidia. Por eso, quienes podrán usar NVHBM serán, ante todo, los socios integrados en el ecosistema correspondiente. Annapurna Labs ha sido el primer participante anunciado: Nvidia indicó que la compañía dará soporte a NVLink Fusion en Trainium4, pero no afirmó expresamente que Trainium4 vaya a utilizar NVHBM.
Por ahora, NVHBM parece una tecnología del futuro que podría llegar al escenario cuando HBM4E ya se instale a gran escala en los aceleradores. El blog técnico de Nvidia afirma que NVHBM se basa en la misma tecnología que la compañía aplicará a sus futuras GPU. Sin embargo, Nvidia aún no ha anunciado cuál será la primera generación de GPU con soporte nativo para NVHBM.
PEREC.RU
Nvidia amplió el 26 de agosto el programa NVLink Fusion y presentó NVHBM, una arquitectura especializada de memoria de alto rendimiento para aceleradores de inteligencia artificial. La compañía afirma que ofrece hasta un 30 % más de ancho de banda por pila, un 15 % menos de consumo energético de HBM y hasta un 25 % más de superficie útil en el chip del acelerador. La comparación se hizo con muestras del estándar HBM4E, cuyos envíos a gran escala se esperan hacia 2027.
El desarrollo busca resolver el problema del ancho de banda de la memoria, que limita cada vez más el rendimiento de los modelos de IA más avanzados. En el esquema habitual, el fabricante de memoria produce una pila DRAM y un chip base, mientras que el desarrollador del acelerador coloca el controlador de memoria y la interfaz física en el chip de cálculo. Una amplia conexión paralela estandarizada por JEDEC los une.
NVHBM cambia la distribución de los componentes: el controlador de memoria se traslada al chip base de la pila tridimensional y el bus paralelo estándar se sustituye por una conexión en serie más estrecha entre chips. Según Nvidia, esto podría reducir hasta un 67 % la superficie de la interfaz y de los elementos auxiliares frente a HBM4E, manteniendo las ventajas en velocidad y consumo energético.
Sin embargo, el principio básico no es del todo nuevo. En diciembre de 2024, Marvell describió una arquitectura similar y señaló a Micron, Samsung y SK hynix como socios. Marvell prometió hasta un 25 % más de superficie de cálculo, hasta un 33 % más de capacidad de memoria y hasta un 70 % menos de consumo energético de la interfaz. Neil Shah, analista de Counterpoint Research, señaló que la tecnología no era nueva y que el cambio clave estaba en su difusión y disponibilidad.
El primer socio de Nvidia anunciado públicamente ha sido Amazon Annapurna Labs. Nvidia indicó que Annapurna dará soporte a NVLink Fusion en Trainium4, pero no confirmó directamente que ese producto vaya a utilizar NVHBM.
El acceso a NVHBM está limitado al ecosistema NVLink Fusion, el programa de Nvidia para conectar aceleradores de terceros a su plataforma de rack. Esto significa que, por ahora, la tecnología no es un estándar universal y abierto.
HBM4E tampoco se fabrica aún a gran escala: Samsung empezó a enviar las primeras muestras a finales de mayo de 2026 y SK hynix lo hizo hacia junio. NVHBM podría aparecer después de la adopción generalizada de HBM4E. Nvidia afirma que empleará la misma base tecnológica en futuras GPU, pero no ha identificado la primera generación con soporte nativo para NVHBM.