Microsoft desafía a Nvidia con su propio chip de IA, Maia 300

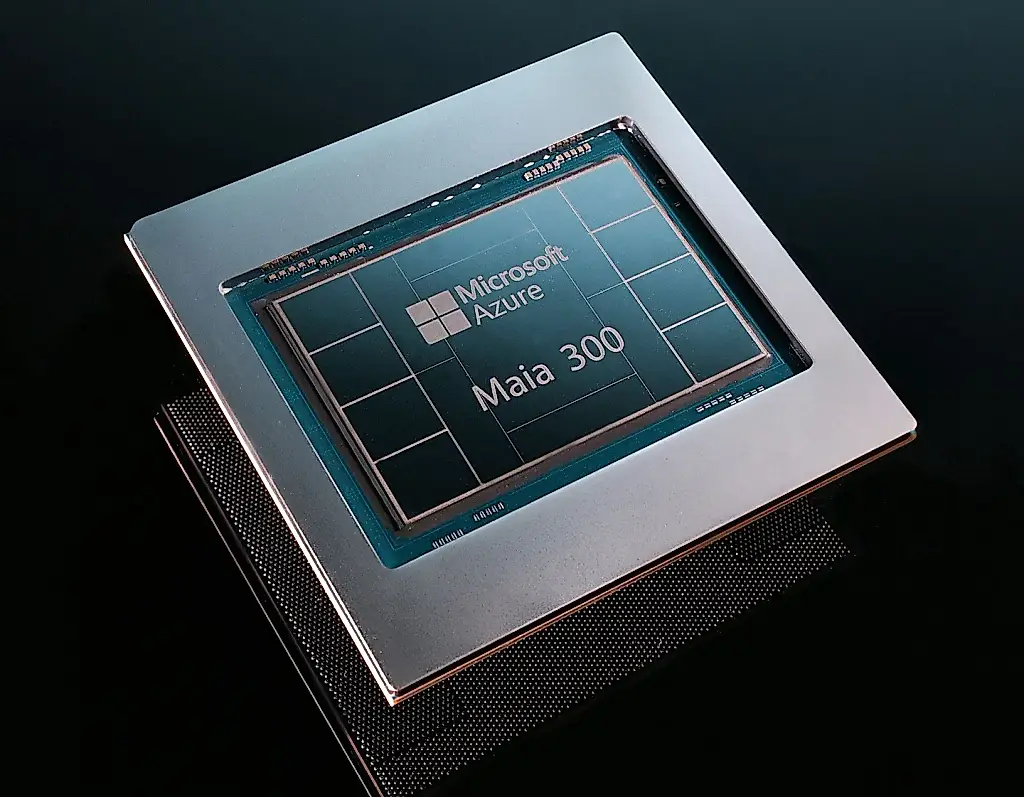
Microsoft apuesta por sus propios chips de IA. La compañía planea desplegar aceleradores Azure Maia a una escala de varios gigavatios a partir de 2027 y convertir Maia en su sistema principal para la inferencia, la fase en la que un modelo ya entrenado responde a las consultas de los usuarios. Esto podría reducir la dependencia de Microsoft de Nvidia, uno de los mayores proveedores de aceleradores de IA, pero por ahora no significa que vaya a dejar de comprar a sus competidores.
En 2024, Microsoft dijo a la Comisión Europea que Google era la única empresa integrada verticalmente en todos los niveles de la IA: desde los chips hasta la tienda de aplicaciones móviles. Según Microsoft, las demás tenían que apoyarse en alianzas. Ahora, la propia compañía avanza hacia un modelo similar.
Scott Guthrie, vicepresidente ejecutivo de Microsoft para la nube y la IA, informó de los planes. Rani Borkar, responsable de Azure Hardware Systems and Infrastructure, y Saurav Dighe, vicepresidente de planificación y arquitectura de sistemas, presentaron los detalles de la arquitectura de Maia 300.
Maia 300 pasa de un único chip, como Maia 200, a un diseño multichip. Los chips de cálculo se fabrican con el proceso N2P de TSMC, mientras que los controladores de memoria y las funciones de entrada y salida se sitúan en chips separados. El acelerador incorpora ocho pilas de memoria HBM4, con una capacidad total de 288 GB y un ancho de banda de 18 TB/s. A modo de comparación, Maia 200 tenía 216 GB y 7,1 TB/s.
Microsoft no se limita a aumentar la potencia de cálculo: también desplaza el foco hacia la memoria. Durante la decodificación —la generación de una respuesta token a token—, el acelerador suele esperar a que los datos lleguen desde la memoria en lugar de realizar cálculos. Esto es especialmente importante para los razonamientos largos del modelo y los ciclos de los agentes de IA, que recurren repetidamente al modelo y a distintas herramientas.
Maia 300 debería reducir la latencia al situar los datos más cerca de las unidades de cálculo. Para ello, emplea una estructura de memoria heterogénea entre chiplets, SRAM integrada controlada por software y formatos numéricos más compactos, entre ellos una versión mejorada de MXFP4 y formatos de almacenamiento con una precisión inferior a tres bits. El hardware puede convertir los datos entre formatos.
La estrategia anunciada refleja una tendencia general: para las grandes empresas de nube, los aceleradores propios han dejado de ser un experimento secundario y se han convertido en una forma de controlar los costes y quedarse con una mayor parte de los beneficios. Google ya vende sistemas basados en sus TPU a clientes que los instalan en sus propios centros de datos. La directora financiera de Alphabet, Anat Ashkenazi, informó de ingresos por estas entregas en el segundo trimestre, y el consejero delegado de la compañía, Sundar Pichai, habló de una fuerte demanda de los TPU como sistemas independientes.
Otras empresas también desarrollan sus propias soluciones. Anthropic reservó a través de Broadcom una capacidad de TPU de 3,5 GW para 2027, además de un acuerdo anterior que contempla hasta un millón de TPU. En 2025 se informó de que Meta negociaba el alquiler de estos chips con opción a comprarlos posteriormente. Amazon desarrolla los procesadores Trainium, Graviton y Nitro. En abril de 2026, Andy Jassy afirmó que los ingresos anuales del negocio de chips de Amazon habían superado los 20.000 millones de dólares, situándolo entre los tres mayores negocios de chips para centros de datos. Por su parte, OpenAI reveló información sobre su propio acelerador, Jalapeño.
La razón del interés por los chips propios queda clara en las cuentas de Nvidia. En el trimestre cerrado en julio de 2026, la compañía ingresó 96.200 millones de dólares, de los que 89.000 millones procedieron de los centros de datos; el margen bruto fue del 75%. La directora financiera de Nvidia, Colette Kress, cifró en 49.000 millones de dólares los ingresos procedentes de los hiperescaladores, las mayores empresas de servicios en la nube. Es decir, algo más de la mitad de las ventas de Nvidia para centros de datos corresponde a un grupo relativamente reducido de grandes clientes, muchos de los cuales ahora diseñan sus propios aceleradores.
Si una empresa traslada parte de la inferencia a sus propios chips, paga un precio más próximo al coste de fabricación y no al precio con el elevado margen de Nvidia. En julio, Microsoft dijo a los inversores que operar Maia 200 podía costar hasta un 40% menos que los chips más recientes de Nvidia al trabajar con modelos de OpenAI y Microsoft. Sin embargo, no indicó qué tarjeta gráfica concreta había utilizado para la comparación y se limitó a hablar de «un sistema líder basado en GPU». Esto dificulta evaluar el resultado, sobre todo teniendo en cuenta que Nvidia destaca la eficiencia de su nueva plataforma Vera Rubin.
El mercado reaccionó con moderación: el lunes posterior a la presentación, las acciones de Nvidia bajaron un 1,29% y las de Microsoft subieron un 1,14%. Según los analistas de Evercore ISI, para el primer trimestre de 2027 Maia representará solo alrededor del 10% del gasto de Microsoft en chips de IA. Nvidia, por su parte, había previsto unos ingresos de 108.000 millones de dólares para el trimestre en curso.
También está la cuestión práctica de la escala. Un rack de Maia 300 consume 167 kW. Para obtener un gigavatio de potencia solo en los racks harían falta unos 6.000, o alrededor de 575.000 aceleradores; la refrigeración y la infraestructura del centro de datos exigirían energía adicional.
Tener chips propios no significa renunciar a Nvidia. Según las estimaciones disponibles, Amazon recibirá más de tres millones de aceleradores de Nvidia para mediados de 2028, pese al gran negocio de procesadores propios de la compañía. Alphabet elevó su previsión de inversiones de capital para 2026 a entre 195.000 y 205.000 millones de dólares y sigue mencionando Vera Rubin junto con sus TPU; Ashkenazi señaló que la empresa está limitada por la disponibilidad de suministros. Microsoft también sigue usando chips de Nvidia y AMD para entrenar modelos. En 2026, Satya Nadella explicó que la posibilidad de integrarse verticalmente no significa que la empresa vaya a depender exclusivamente de sus propios desarrollos.
El consejero delegado de Nvidia, Jensen Huang, sostiene que muchos aceleradores especializados están concebidos para la inferencia en una sola nube o servicio, mientras que Nvidia ofrece una plataforma de aplicación más amplia. El contraargumento de Microsoft es sencillo: una sola nube puede bastar, si es lo bastante grande.
Pero los chips propios redistribuyen los beneficios; no necesariamente reducen el gasto total en IA. Gartner advierte de que, para obtener un rendimiento razonable de las inversiones en infraestructura, el sector necesitará unos 8,5 billones de dólares de ingresos entre 2026 y 2030, mientras que los ingresos previstos por IA no superarán los 3,6 billones. Microsoft no está frenando la construcción, sino que planea desplegar aún más capacidad. Un cálculo más barato puede ayudar a reducir el precio de la IA y ampliar la demanda, en vez de reducir necesariamente el gasto del sector en su conjunto.
Además, una parte considerable de los costes seguirá yendo a parar a los proveedores de componentes. Maia 300 depende de la escasa memoria HBM4 —Nvidia ha anunciado la misma capacidad, 288 GB por paquete, para Rubin—, y TSMC fabrica los chips de cálculo para distintos clientes. Los TPU de Google se desarrollan y suministran con la participación de Broadcom en virtud de un acuerdo a largo plazo. El consejero delegado de Broadcom, Hock Tan, advirtió de que muchos inversores no entienden en qué están invirtiendo y auguró que la escasez de chips solo se aliviará en 2028 o 2029.
Nvidia también se prepara para competir en inferencia: pagó 20.000 millones de dólares por una licencia de la tecnología de decodificación SRAM de Groq. Mientras no se entreguen los Maia 300 de producción y clientes independientes no comprueben sus prestaciones, las cifras clave siguen siendo datos de la propia Microsoft. Así que Maia 300 es una apuesta seria por reducir la dependencia de Nvidia, pero no demuestra que su negocio vaya a desplomarse pronto. La mayor amenaza para los márgenes de Nvidia quizá no venga de sus competidores habituales, sino de sus principales clientes, que también son sus mayores compradores.
PEREC.RU
El texto analiza los planes de Microsoft para desarrollar su acelerador de IA Maia 300 y cómo el paso de las grandes empresas de nube a chips propios podría afectar a Nvidia. El autor subraya que no se trata de un chip más, sino de un intento de Microsoft de controlar el coste y la infraestructura de la inferencia, la fase en la que un modelo ya entrenado responde a las consultas. La compañía quiere desplegar Maia a una escala de varios gigavatios a partir de 2027 y convertirla en el sistema principal de inferencia para sus productos y servicios.
Maia 300 pasa del chip único de Maia 200 a un diseño multichip. TSMC fabrica los chips de cálculo con el proceso N2P, mientras que los controladores de memoria y las funciones de entrada y salida se trasladan a chips separados. El acelerador usa ocho pilas de HBM4, con un total de 288 GB y un ancho de banda de 18 TB/s; Maia 200 tenía 216 GB y 7,1 TB/s. La arquitectura busca reducir la latencia de memoria: al generar tokens, realizar razonamientos largos y ejecutar ciclos de agentes de IA, los aceleradores suelen estar esperando los datos. Microsoft recurre a una disposición heterogénea de la memoria entre chiplets, SRAM integrada controlada por software, el formato MXFP4 mejorado y formatos de almacenamiento de menos de tres bits de precisión, con conversión por hardware entre ellos.
El paso de Microsoft refleja una tendencia general entre los hiperescaladores, los mayores proveedores de servicios en la nube. En 2024, Microsoft describió a Google como la única empresa integrada en toda la cadena de la IA, desde los chips hasta las aplicaciones. Ahora Google obtiene ingresos por la venta de sistemas TPU; Anthropic reservó a través de Broadcom 3,5 GW de capacidad TPU para 2027 y ya había acordado recibir hasta un millón de chips. En 2025 se informó de negociaciones de Meta para alquilar TPU con opción de compra posterior. Amazon desarrolla Trainium, Graviton y Nitro; Andy Jassy afirmó que los ingresos anuales de su negocio de chips habían superado los 20.000 millones de dólares. OpenAI presentó el acelerador Jalapeño.
El motivo económico está relacionado con los márgenes de Nvidia. En el trimestre cerrado en julio de 2026, la compañía ingresó 96.200 millones de dólares, 89.000 millones procedentes de los centros de datos, con un margen bruto del 75%. Según su directora financiera, Colette Kress, los hiperescaladores aportaron 49.000 millones, algo más de la mitad de los ingresos de centros de datos. Si los grandes clientes trasladan la inferencia a aceleradores propios, podrán pagar un precio más cercano al coste de fabricación, en lugar de uno que incluya el margen de Nvidia.
Microsoft afirmó que operar Maia 200 podía costar hasta un 40% menos que los chips más recientes de Nvidia al trabajar con modelos de Microsoft y OpenAI. Pero no precisó con qué GPU hizo la comparación, por lo que resulta difícil confirmar la ventaja. Tras el anuncio de Maia 300, las acciones de Nvidia bajaron un 1,29% y las de Microsoft subieron un 1,14%. Evercore ISI calcula que Maia representará aproximadamente el 10% del gasto de Microsoft en chips de IA para el primer trimestre de 2027; Nvidia había previsto unos ingresos de 108.000 millones de dólares para el trimestre en curso.
Ampliar la escala exige una infraestructura enorme: un rack de Maia 300 consume 167 kW. Para alcanzar un gigavatio de potencia en racks se necesitarían unos 6.000, o aproximadamente 575.000 aceleradores, sin contar la refrigeración y otros costes del centro de datos. Tener chips propios no implica renunciar a Nvidia. Amazon prevé recibir más de tres millones de sus GPU para mediados de 2028. Alphabet elevó su previsión de inversiones de capital para 2026 a entre 195.000 y 205.000 millones de dólares, y utiliza tanto TPU como Vera Rubin, aunque está limitada por los suministros. Microsoft sigue usando chips de Nvidia y AMD para entrenar modelos; Satya Nadella dijo que la integración vertical no significa depender exclusivamente de soluciones propias.
Según Jensen Huang, consejero delegado de Nvidia, muchos aceleradores especializados están diseñados para la inferencia en una sola nube o servicio, mientras que Nvidia ofrece una plataforma de uso más amplio. Microsoft responde que una sola nube puede bastar si es lo suficientemente grande. Sin embargo, el paso a chips propios modifica sobre todo el reparto de los beneficios, no el volumen total de inversión. Gartner calcula que, para que las inversiones del sector tengan un rendimiento razonable, los ingresos entre 2026 y 2030 deberían rondar los 8,5 billones de dólares, mientras que los ingresos previstos por IA no superan los 3,6 billones. Microsoft pretende ampliar su infraestructura, y unos cálculos más baratos podrían aumentar la demanda.
Los proveedores de componentes también mantienen su cuota: Maia depende de la escasa memoria HBM4 y de TSMC; Nvidia ha anunciado para Rubin una capacidad similar, 288 GB por paquete. Los TPU de Google se fabrican con la participación de Broadcom. Su consejero delegado, Hock Tan, espera que la escasez de chips solo se alivie en 2028 o 2029. Nvidia también responde al desarrollo de la inferencia: pagó 20.000 millones de dólares por una licencia de la tecnología de decodificación SRAM de Groq.
La conclusión del artículo es que Maia 300 es, por ahora, un proyecto descrito de forma convincente, pero no una alternativa probada de manera independiente. Aún no se han entregado chips de producción y los clientes externos no han verificado las prestaciones anunciadas; las cifras clave solo las conoce Microsoft. Por tanto, su lanzamiento no implica un desplome inminente de Nvidia. La amenaza más seria para sus márgenes podría venir de sus mayores clientes, que siguen comprando sus aceleradores mientras desarrollan los suyos propios.